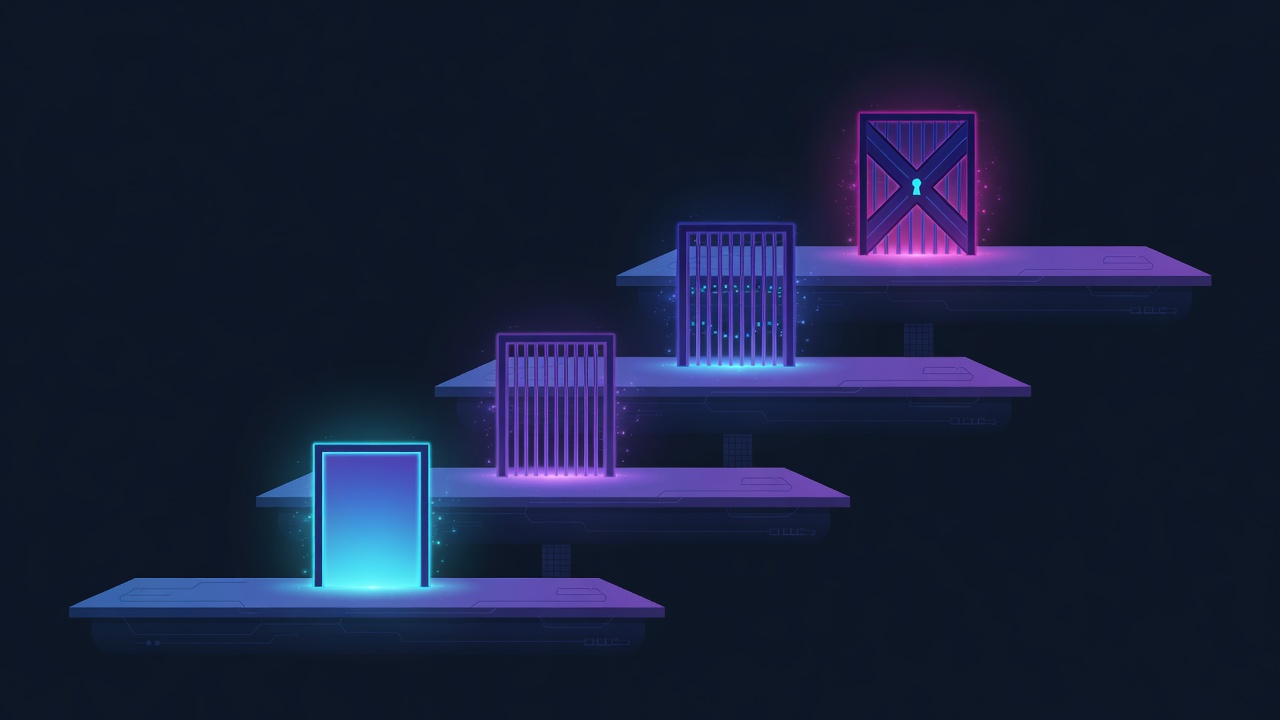
Autonomía por niveles de riesgo: cómo Koinessa controla la autoridad de los agentes
Quieres el apalancamiento. No quieres el informe de incidente. Todo fundador técnico que ejecuta agentes de IA contra una base de código real choca con la misma pared: los agentes son lo bastante rápidos como para ser peligrosos, y las únicas dos configuraciones disponibles parecen ser «apruébalo todo tú mismo, para siempre» o «déjalo correr y espera lo mejor». La primera te convierte en el cuello de botella de cada actualización de dependencia. La segunda significa que un proceso autónomo puede borrar datos, hacer push a producción o enviarle un correo a un cliente mientras duermes. Ninguna de las dos es un modelo operativo.
Hay una tercera opción, y no es nueva. Es la respuesta a la que llegaron las disciplinas de ingeniería maduras hace décadas: clasifica las acciones según su radio de impacto, haz que los controles sean proporcionales al riesgo, y codifica esos controles como artefactos verificables y versionados, en lugar de vibes en un prompt. Esta entrada amplía la Sección 5 del libro blanco del cerebro de Koinessa, que convierte esa respuesta en un sistema funcional mediante dos ejes de nivel legibles por máquina — y muestra qué cuesta cruzar un límite entre ellos.
La falsa disyuntiva entre el todo manual y el todo autónomo
La revisión manual completa no escala con el rendimiento de los agentes, y la autonomía completa no sobrevive el contacto con acciones irreversibles. La estratificación por niveles vence a ambas porque se niega a tratar «lo que el agente está haciendo» como una sola categoría. Escribir un índice de documentación y borrar una tabla de producción son, las dos, «acciones que el agente realizó», pero difieren en órdenes de magnitud en cuanto a reversibilidad, radio de impacto y la evidencia que querrías tener antes de permitirlas. Una sola puerta para ambas, o bien estrangula el 90 por ciento seguro, o bien deja pasar el 10 por ciento peligroso.
Vale la pena expresar con precisión el planteamiento del libro blanco: la autonomía debe expandirse demostrando qué clases de acción se pueden delegar bajo qué controles — nunca declarando que un sistema es autónomo. Esa es una afirmación sobre el proceso, no sobre la calidad del modelo. Un modelo mejor no cambia el radio de impacto de DROP TABLE; solo cambia con cuánta confianza se comete el error.
Dos ejes, una disciplina
Koinessa mantiene dos ejes de nivel, y miden cosas distintas. Confundirlos es como se pudren los sistemas de permisos.
El primer eje es el nivel de verificación R0-R3 (designador AAV-001, en vivo). Cada elemento de trabajo recibe un nivel legible por máquina que deriva de forma determinística sus puertas requeridas, su requisito de brief y su política de aprobación. Este eje responde: ¿cuánto rigor le debe este elemento de trabajo?
El segundo eje es el nivel de acción 1-4 (EGA-001, en vivo), que clasifica las clases de acción según su radio de impacto, de reversible a irreversible, evaluado en modo fail-closed por una política versionada. Responde: ¿qué tan peligrosa es esta clase de acción, sin importar quién o qué la solicite?
El eje de acción, con la correspondencia nominal de elemento de trabajo entre paréntesis:
- Nivel 1 (R0) — reversible, de bajo impacto. Documentación, índices generados, formateo, investigación. Automatización amplia una vez que la evidencia está completa.
- Nivel 2 (R1) — cambios de ingeniería acotados. Cambios pequeños de código, actualizaciones de dependencias, refactorizaciones internas, generación de pruebas. Puertas determinísticas; revisión humana en límites seleccionados, no en todas partes.
- Nivel 3 (R2) — acciones externas con consecuencias. Despliegue a producción, eliminación de datos, medios pagados, comunicación con clientes, transacciones financieras. Estas reciben credenciales limitadas, aprobaciones explícitas, ejecución idempotente y una ruta de rollback probada — las credenciales están delimitadas de modo que exceder una aprobación sea estructuralmente difícil, no simplemente desalentado.
- Nivel 4 (R3) — irreversible o crítico para la seguridad. Autorizado por humanos, potencialmente con revisión independiente, simulación o análisis formal. Algunas acciones nunca deberían delegarse por completo, y un sistema creíble lo dice.
Un matiz honesto que imprime el libro blanco: los dos ejes chocaron en los nombres de tipo durante el desarrollo, y un elemento de trabajo (EGD-002) elimina la colisión residual y fija la correspondencia como un módulo probado. Así se ve un modelo de niveles cuando es código y no diapositivas — las costuras se rastrean como trabajo de ingeniería.
Política como código versionado, no como texto de prompt
La decisión que sostiene todo el diseño es dónde vive la lógica de permisos. Si la regla «los agentes no pueden borrar datos de producción sin aprobación» existe únicamente como una frase en un system prompt, la hace cumplir el mismo proceso estocástico que se supone que debe restringir. El texto de un prompt es orientativo. Se desvía con las versiones del modelo, se trunca bajo presión de contexto, y no se le puede hacer diff, ni probar, ni auditar.
El ecosistema cloud-native resolvió esto hace años. Open Policy Agent — un proyecto graduado de la CNCF y la referencia que cita el libro blanco para este patrón — es un motor de políticas de propósito general construido sobre una idea: desacoplar la toma de decisiones de política de su aplicación, y expresar la política en un lenguaje declarativo (Rego) para que «qué acciones están permitidas bajo qué condiciones» sea código, evaluado contra una entrada estructurada. Política como código significa que la regla tiene un historial de versiones, una suite de pruebas y un rastro de revisión, exactamente igual que el resto de tu ingeniería. El libro blanco es cuidadoso aquí: OPA es una fuente para el patrón general, y Koinessa no afirma incorporar OPA. Lo que Koinessa toma es la disciplina — permisos evaluados contra una política versionada con decisiones persistidas, de modo que cada allow o deny es en sí mismo un recibo que puedes reproducir.
Esto es también lo que le da sentido a la propiedad fail-closed. Cuando la evaluación de la política no puede producir una decisión positiva, el valor predeterminado es el rechazo, no el mejor esfuerzo. Un sistema de niveles fail-open es un simple ejercicio de etiquetado.
El NIST ya escribió la descripción del puesto
Nada de esto requiere inventar un vocabulario de gobernanza. Dos publicaciones del NIST hacen la mayor parte del trabajo de encuadre, y el libro blanco mapea sus controles explícitamente sobre ellas.
El NIST AI Risk Management Framework — AI RMF 1.0, publicado el 26 de enero de 2023, con el Generative AI Profile (NIST AI 600-1) publicado después, el 26 de julio de 2024 — es un marco voluntario para incorporar la confiabilidad en el diseño, desarrollo, uso y evaluación de sistemas de IA. Su movimiento central es el mismo que la autonomía por niveles hace concreto: la gestión de riesgo de IA no es una postura que declaras, es un conjunto de funciones que operas continuamente, con un rigor proporcional al riesgo del caso de uso. Un generador de documentación y un pipeline de despliegue autónomo son ambos «sistemas de IA», y la premisa del RMF es que tratarlos de forma idéntica es un error de categoría.
El segundo anclaje es el NIST Secure Software Development Framework, SP 800-218 v1.1 (febrero de 2022), más el SP 800-218A, el SSDF Community Profile de IA generativa finalizado en 2024. El SSDF existe porque pocos modelos de SDLC abordan la seguridad en detalle, así que aporta un conjunto central de prácticas y un vocabulario común que los compradores de software pueden usar con sus proveedores. La sección de limitaciones del libro blanco es directa sobre lo que esto significa para el propio Koinessa: los marcos son orientación, un control es un comportamiento implementado, la evidencia demuestra que el comportamiento ocurrió, y la certificación es una determinación aparte que la plataforma no ha atravesado. Ese orden es exactamente la respuesta de auditoría que un sistema por niveles está construido para preservar.
Cruzar un límite de nivel debe costar ceremonia
El párrafo más contundente de la Sección 5 no habla de política. Habla de una migración de base de datos. Renombrar la clave de identidad estampada en cada fila del cerebro de Koinessa — parte de la clave primaria en muchas tablas — suena como una sola sentencia UPDATE. En cambio, el sistema la ejecutó como cuarenta y siete reconstrucciones secuenciales de tabla completa: build, inserción masiva, renombrado atómico, checkpoint, verificación, con 110,811 filas reclasificadas en vivo y cero corrupciones. La razón es la mejor parte: una actualización de clave in situ anterior había corrompido la base de datos. Se eligió el camino caro porque el camino barato ya había fallado una vez, en producción, con recibos.
Esa es la filosofía del modelo de niveles en miniatura. Los límites de nivel solo son creíbles cuando cruzarlos cuesta ceremonia — criterios medidos, registrados por cada activación: tasas de colisión, tasas de workers obsoletos, tasas de éxito verificado, frecuencia de intervención humana, efectividad del rollback. La promoción se gana con historial operativo, nunca se concede porque el sistema haya estado tranquilo últimamente. La tranquilidad no es evidencia. Esta es la misma disciplina detrás del desarrollo con evidencia como puerta: el bucle no corrige su propia tarea, y la puerta no se relaja porque aprobar se haya vuelto rutinario.
No habilitado es una característica, no una confesión
La ruta de Autopilot de Koinessa — la maquinaria que lleva un documento de requisitos aprobado, a través de la implementación, hasta un pipeline verde verificado — está etiquetada como No habilitado, y la etiqueta es deliberadamente poco vistosa. Ha corrido simulacros en vivo supervisados de principio a fin. Su postura, bloqueada por decisión, es fail-closed, y volver a armarla es una acción explícita del operador, no un timeout que expira en silencio.
Esto importa para cómo interpretas las etiquetas de capacidad en general. El libro blanco publica un informe de estado y limitaciones junto a la arquitectura: en vivo, en curso, no habilitado y planeado son afirmaciones distintas, y confundirlas es como las presentaciones de los proveedores te mienten. Un sistema que te dice qué partes todavía no se atreve a confiarse a sí mismo te da información más utilizable que uno que reclama autonomía total. Los sistemas deberían ganar autoridad a partir de su historial operativo, y el proceso de ganársela debería ser aburrido.
Elevar la autonomía sin perder la respuesta de auditoría
La recompensa de toda esta estructura no es la cautela por sí misma — es que la autonomía se vuelve elevable. Cuando cada elemento de trabajo lleva su nivel de verificación, cada clase de acción lleva su calificación de radio de impacto, y cada decisión de permiso es un registro persistido evaluado contra una política versionada, entonces «darles más cuerda a los agentes» deja de ser un salto de fe y se convierte en un experimento controlado. Promueves una clase de acción, en un eje, con criterios medidos frente a ti, y el registro de auditoría de qué cambió y por qué se escribe solo. Los paquetes de evidencia se corresponden con las expectativas de garantía al estilo SSDF, así que cuando un cliente, un inversionista o un revisor de seguridad pregunta «¿quién autorizó esto, bajo la autoridad de quién, con qué prueba?», la respuesta es evidencia firmada en lugar de garantías. Esa es la diferencia entre la automatización con puertas humanas y esperar que tu prompt haya sido lo bastante severo.
La conclusión
No tienes que elegir entre ser el cuello de botella de las aprobaciones y entregarle decisiones irreversibles a un agente sin control. Clasifica los elementos de trabajo según el rigor que deben (R0-R3), clasifica las acciones según su radio de impacto (niveles 1-4), codifica la lógica de permisos como una política versionada, verificable y fail-closed en lugar de texto de prompt, y haz que cada promoción de nivel se la gane frente al historial operativo registrado. Ese es el modelo que expone la Sección 5 del libro blanco del cerebro de Koinessa, con la maquinaria de AAV-001 y EGA-001 detrás. Para entender por qué un sistema operativo de IA necesita esta disciplina en cada capa, no solo en la puerta de permisos, empieza con la visión general de la serie y el libro blanco completo.